Kurz gesagt: Richtig prompten heißt für Power-User: Sie setzen Microsoft 365 Copilot früh ein, beschreiben zuerst das Ziel, lassen Rückfragen zu und prüfen jedes Ergebnis selbst. Eine Studie von Microsoft Research und Salesforce mit 15 Sprachmodellen liefert dazu die wichtigste Regel: alle Angaben in die erste Nachricht. Kommen sie nach und nach, fällt die Leistung im Schnitt von rund 90 auf rund 65 von 100 Punkten.
Was Power-User über ihren Copilot-Alltag erzählen
Power-User sind die Mitarbeitenden, die Copilot täglich nutzen und von denen die Kollegen sich Tipps holen. Für diesen Beitrag habe ich Interviews mit mehreren von ihnen ausgewertet. Die Aussagen unten sind anonymisiert und zusammengefasst, Beispiele teils in andere Zusammenhänge übertragen. Fünf Muster ziehen sich durch.
Fachliche Klarheit schlägt Technikwissen
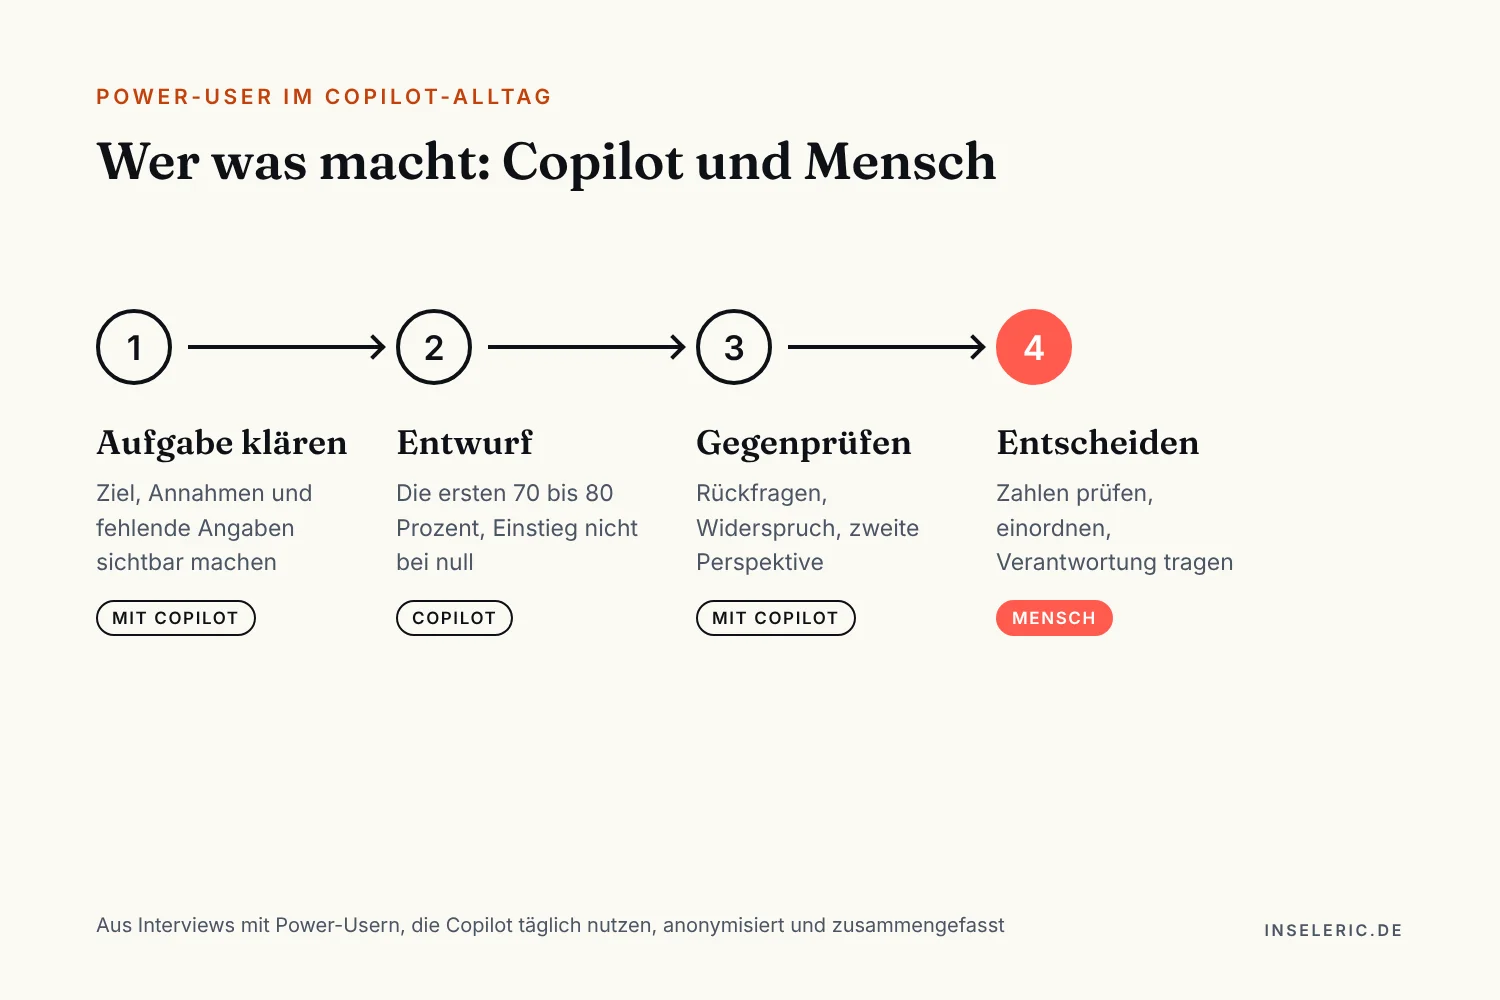
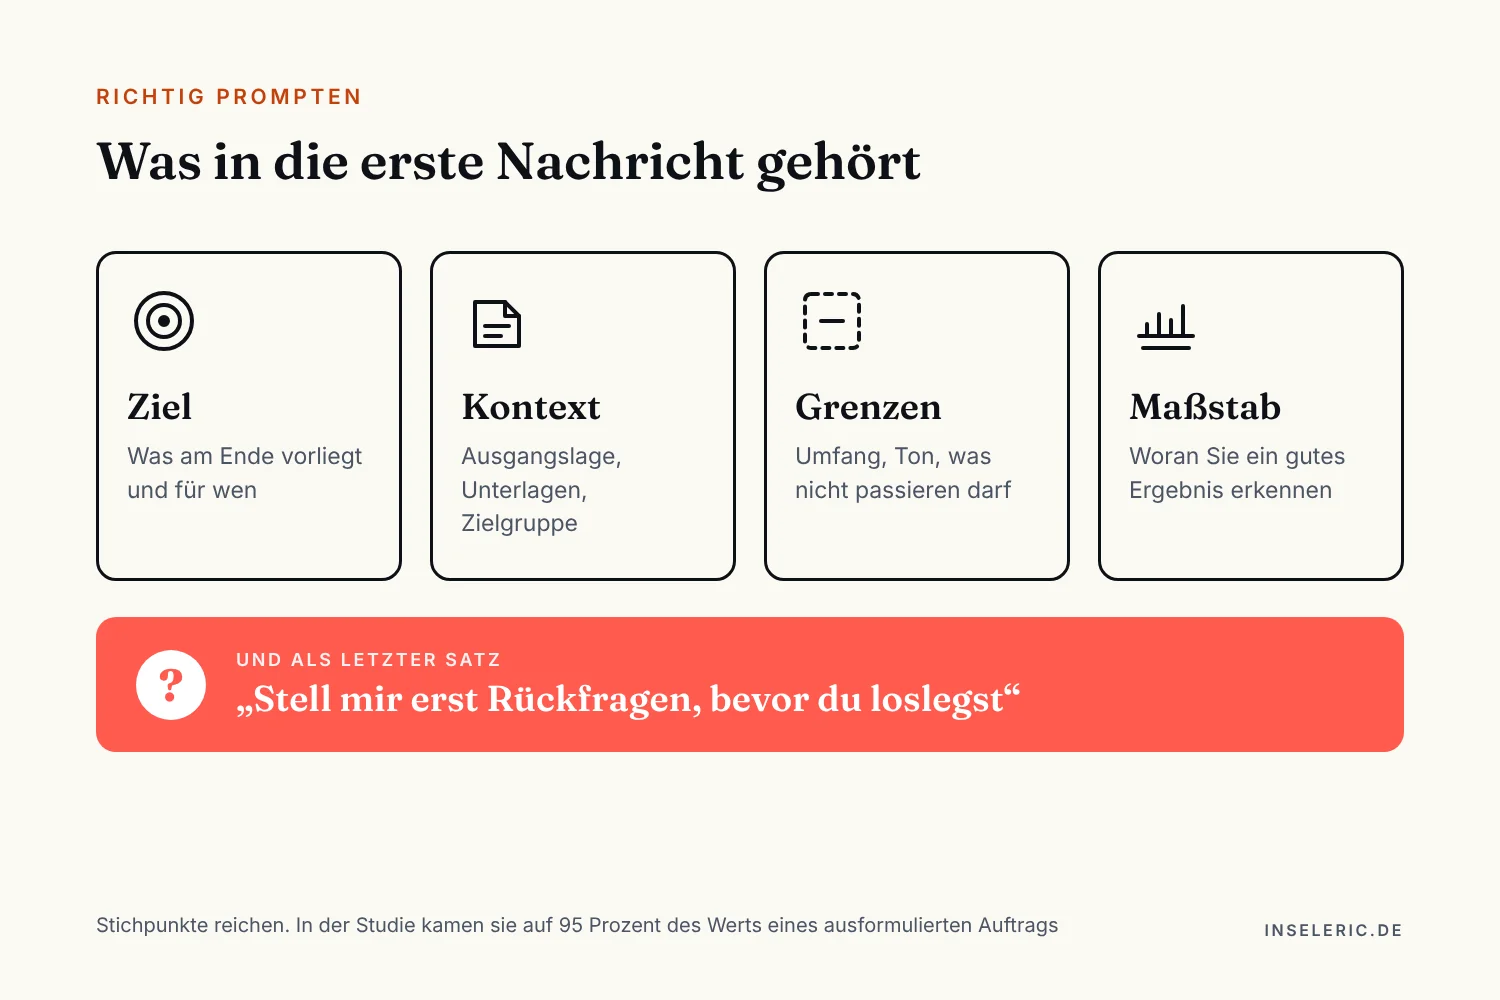
Programmierkenntnisse halten die Power-User nicht für nötig. Wer weiß, welches Ergebnis er braucht, kann Copilot sinnvoll einsetzen. Am Anfang stehen bei ihnen vier Fragen: Was soll am Ende vorliegen? Für wen? Welche Angaben und Grenzen gelten? Woran erkenne ich ein gutes Ergebnis?
Copilot kommt früh zum Einsatz, nicht erst beim fertigen Dokument
Der größte Nutzen entsteht oft vor der eigentlichen Arbeit. Statt „Schreib mir das Konzept“ lassen Power-User zuerst die Aufgabe selbst untersuchen: Annahmen und offene Punkte sichtbar machen, fehlende Angaben finden, Vorgehensweisen vergleichen. Erst danach entstehen Text, Tabelle oder Analyse. So wird Copilot vom Textgenerator zum Denkpartner.
Die ersten 70 bis 80 Prozent gehen schneller, der Rest bleibt Handarbeit
Die Zeitersparnis entsteht selten dadurch, dass Copilot eine Aufgabe fertig erledigt. Sie entsteht, weil niemand mehr bei null anfängt. Prüfen, gewichten, einordnen und entscheiden bleibt menschliche Arbeit. Die Verantwortung für Zahlen und Schlussfolgerungen geben die Power-User nicht ab.
Rückfragen und Widerspruch werden ausdrücklich verlangt
Zwei Anweisungen haben sich bei ihnen bewährt. Die erste verhindert, dass Copilot fehlende Angaben still ergänzt:
Beginne nicht sofort mit der Ausarbeitung. Liste zuerst alle Unklarheiten auf und stelle mir die wichtigsten Rückfragen. Wenn Angaben fehlen, triff keine stillen Annahmen.
Die zweite verhindert, dass Copilot zu schnell zustimmt:
Suche aktiv nach Gegenargumenten, Schwachstellen und Bedingungen, unter denen deine Empfehlung nicht gilt.
Copilot für den Alltag, Copilot Studio für Abläufe
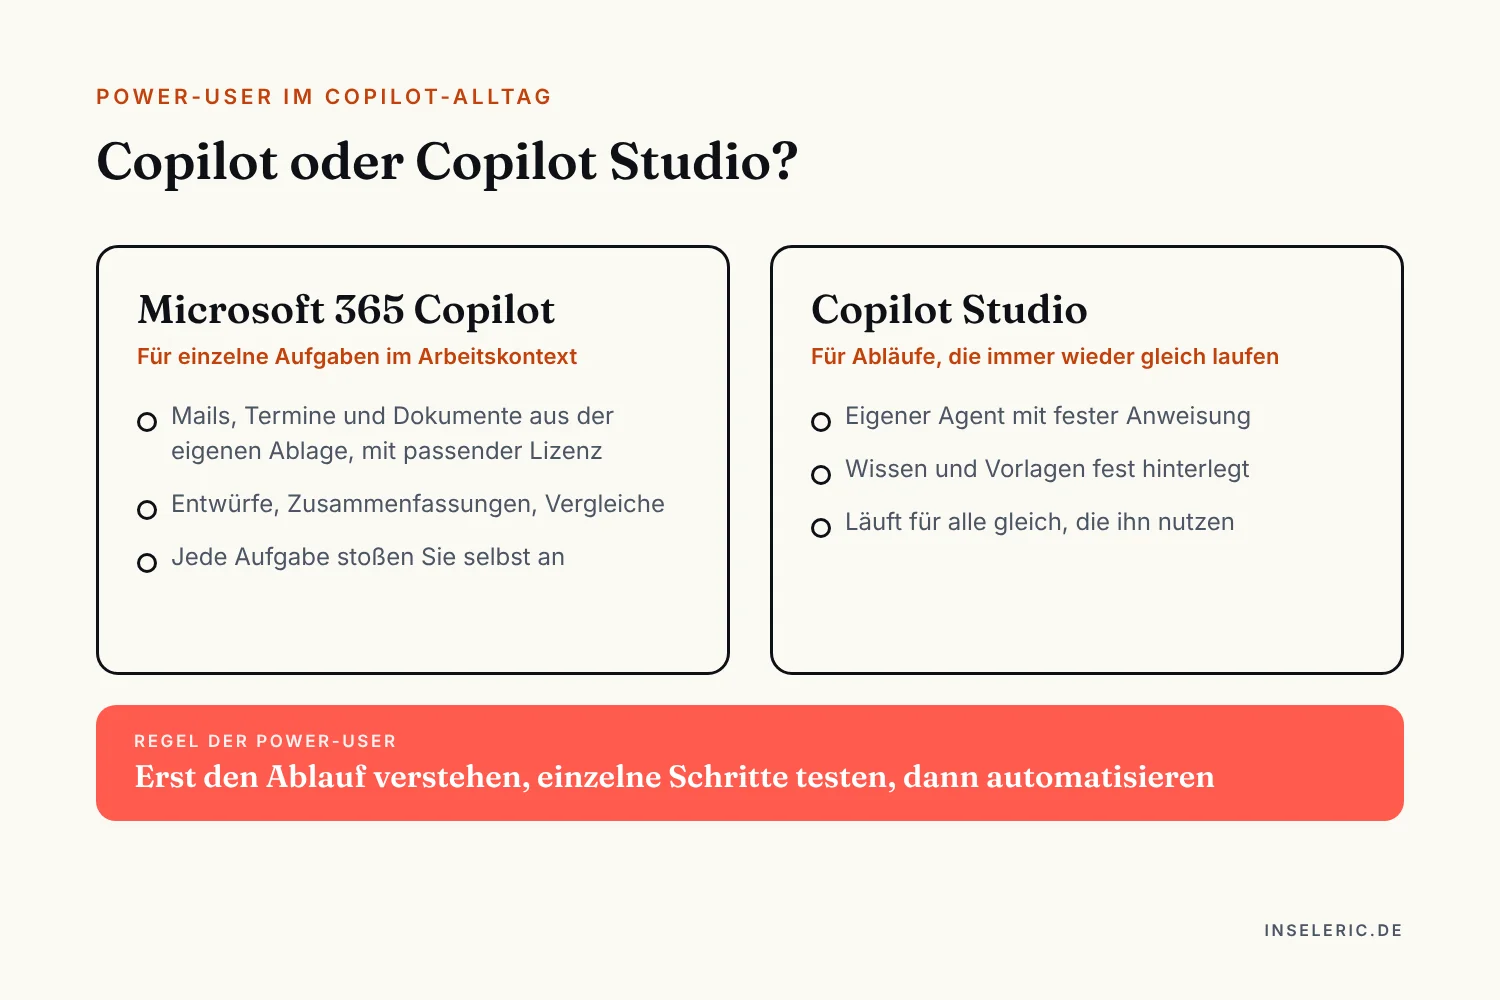
Die Power-User arbeiten mit zwei Werkzeugen. Microsoft 365 Copilot ist stark, wenn es um den Arbeitskontext geht: mit der passenden Lizenz Mails, Termine und Dokumente aus der eigenen Ablage. Für wiederkehrende Abläufe und kleine Automatisierungen bauen sie eigene Agenten in Copilot Studio. Gewählt wird nach Datenzugriff, Art und Umfang der Aufgabe und danach, wie vertraulich die Daten sind.
Typische Fehler aus den Interviews
Dieselben Interviews zeigen auch, was nicht funktioniert:
- Zu kurze Eingaben. Ein Satz ohne Ziel und Zielgruppe liefert ein Allerweltsergebnis. Das liegt meist am Auftrag, nicht am Modell
- Zu hohe Erwartungen an den ersten Versuch. Wer beim ersten Rohentwurf aufgibt, erfährt nie, was mit gezielten Korrekturen möglich gewesen wäre
- Fehlender Zugriff auf Quellen. Kann Copilot die nötigen Dokumente nicht sehen, bleibt die Antwort lückenhaft, auch wenn sie vollständig klingt
- Zu frühe Vollautomatisierung. Gerade beim Bau von Agenten in Copilot Studio gilt: erst den Ablauf verstehen und einzelne Schritte testen, dann automatisieren
- Folien und Layouts. Inhaltlich brauchbar, optisch oft unpassend. Die Gestaltung bleibt Handarbeit
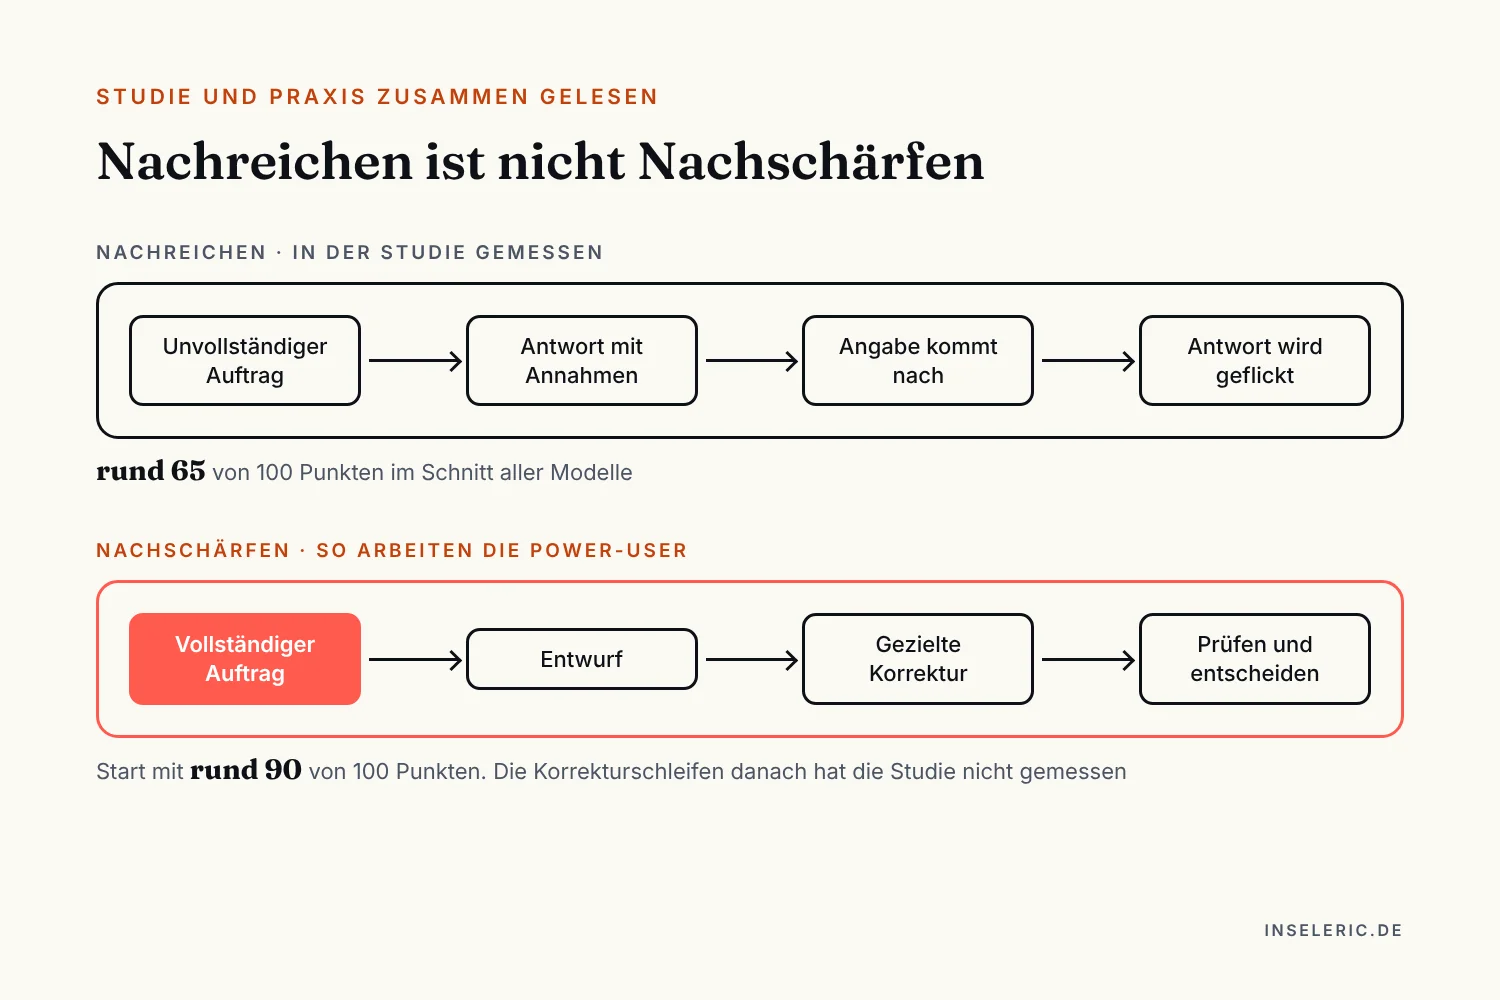
Auffällig ist ein Widerspruch. Die Power-User loben das Arbeiten in kurzen Schleifen: Entwurf, Abweichung benennen, nachschärfen. Eine aktuelle Studie zeigt dagegen, dass Sprachmodelle in Gesprächen über mehrere Nachrichten deutlich schlechter werden. Beides stimmt, und der Unterschied erklärt, wie man richtig promptet.
Was die Studie von Microsoft und Salesforce zeigt
Philippe Laban und Jennifer Neville von Microsoft Research sowie Hiroaki Hayashi und Yingbo Zhou von Salesforce Research haben 15 Sprachmodelle in über 200.000 simulierten Gesprächen geprüft. Die Fachkonferenz ICLR hat die Arbeit 2026 angenommen und für einen Vortrag im Hauptprogramm ausgewählt.
Grundlage waren 600 Aufgaben aus sechs Bereichen, die meisten mit eindeutig prüfbarem Ergebnis: Programmcode, Datenbankabfragen, Textaufgaben aus der Mathematik und Befehle an Software, dazu Tabellenbeschreibungen und Zusammenfassungen. Jede Aufgabe gab es in drei Fassungen:
- Vollständig in einer Nachricht
- Dieselben Angaben als Stichpunkte, ebenfalls in einer Nachricht
- Dieselben Angaben über mehrere Nachrichten verteilt. Ein simulierter Nutzer rückt pro Runde höchstens eine neue Angabe heraus
Getestet wurden unter anderem GPT-4o, GPT-4.1, o3, Claude 3.7 Sonnet, Gemini 2.5 Pro, Llama 4 Scout und DeepSeek-R1, also der Stand vom Frühjahr 2025.
Rund 90 Punkte in einer Nachricht, rund 65 verteilt
Mit allen Angaben in einer Nachricht erreichten die Modelle im Schnitt rund 90 von 100 Punkten. Über mehrere Nachrichten verteilt waren es rund 65. Mit der Länge des Chats hat das wenig zu tun: In einem Zusatztest mit GPT-4o und GPT-4o-mini zeigte sich der Effekt schon ab zwei Runden. Entscheidend ist, dass Angaben nachkommen. Die Stichpunkte in einer Nachricht kamen dagegen auf 95 Prozent des Werts der ausformulierten Fassung. Sie müssen also nicht schön formulieren, nur vollständig.
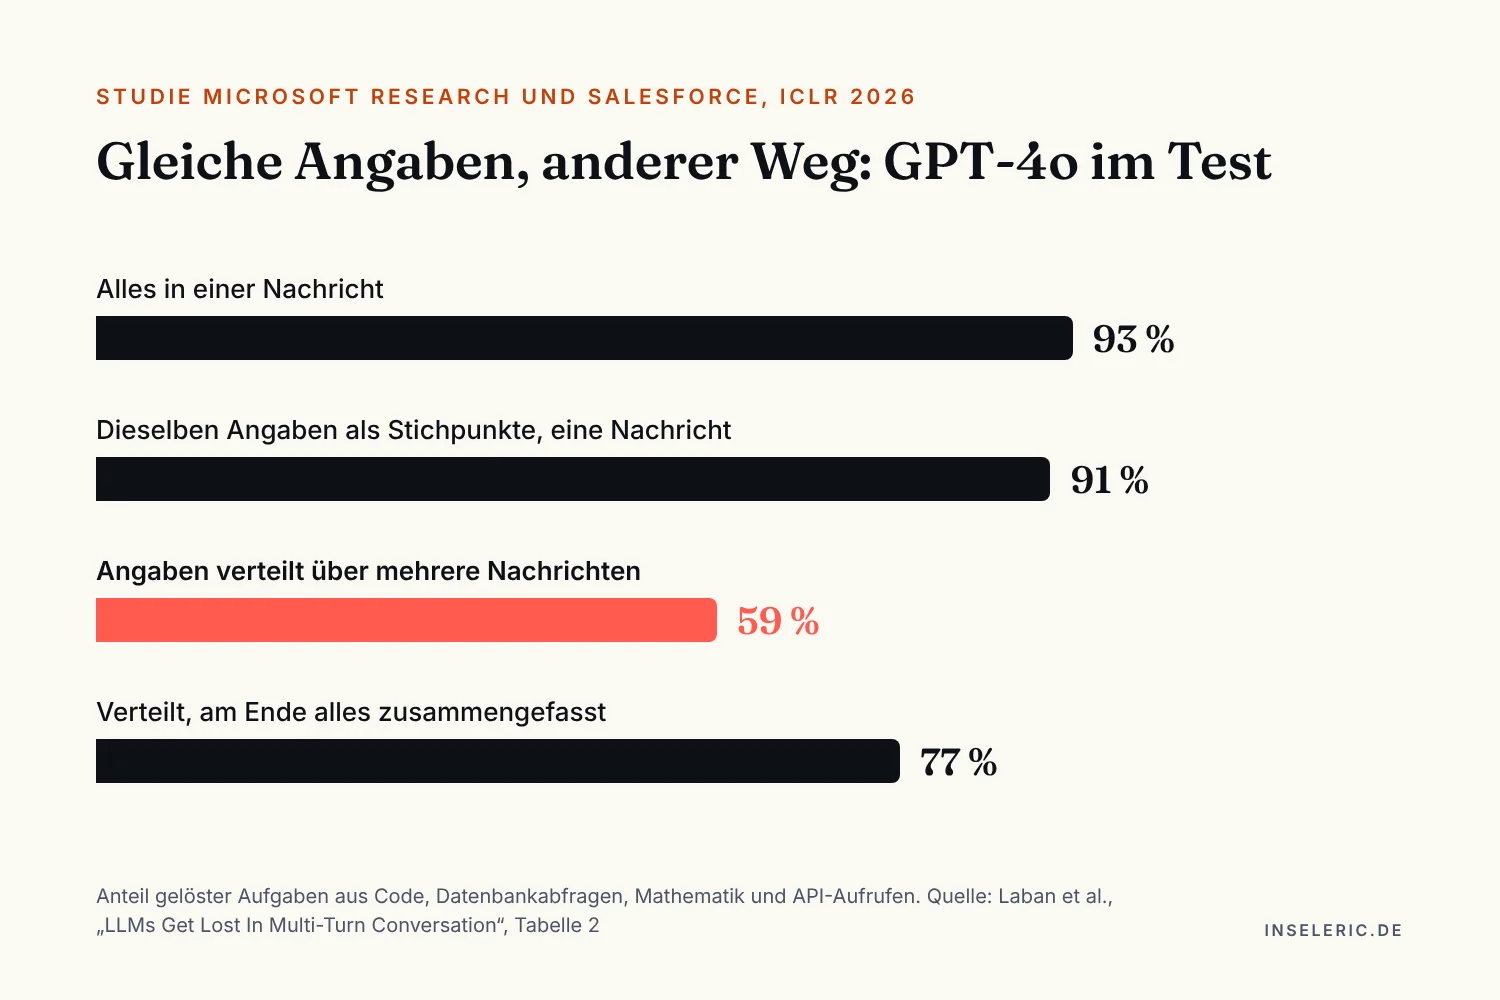
Am Beispiel GPT-4o, gemessen an vier der sechs Aufgabenbereiche: 93 Prozent gelöst mit allem in einer Nachricht, 59 Prozent verteilt. Fasste der simulierte Nutzer am Ende alles noch einmal zusammen, stieg der Wert auf 77 Prozent. Das ist besser, erreicht aber den vollständigen Auftrag von Anfang an nicht.
Kaum schwächer, aber deutlich unberechenbarer
Jede Aufgabe lief zehnmal. Die Leistung in den guten Durchläufen sank im Gespräch über mehrere Nachrichten um 16 Prozent, laut Autoren nicht signifikant. Der Abstand zwischen guten und schlechten Durchläufen derselben Aufgabe stieg dagegen um 112 Prozent, auf mehr als das Doppelte. Ein Ergebnis, das mal stimmt und mal nicht, ist im Alltag gefährlicher als ein durchgehend mittelmäßiges: Man sieht ihm nicht an, welches man gerade vor sich hat.
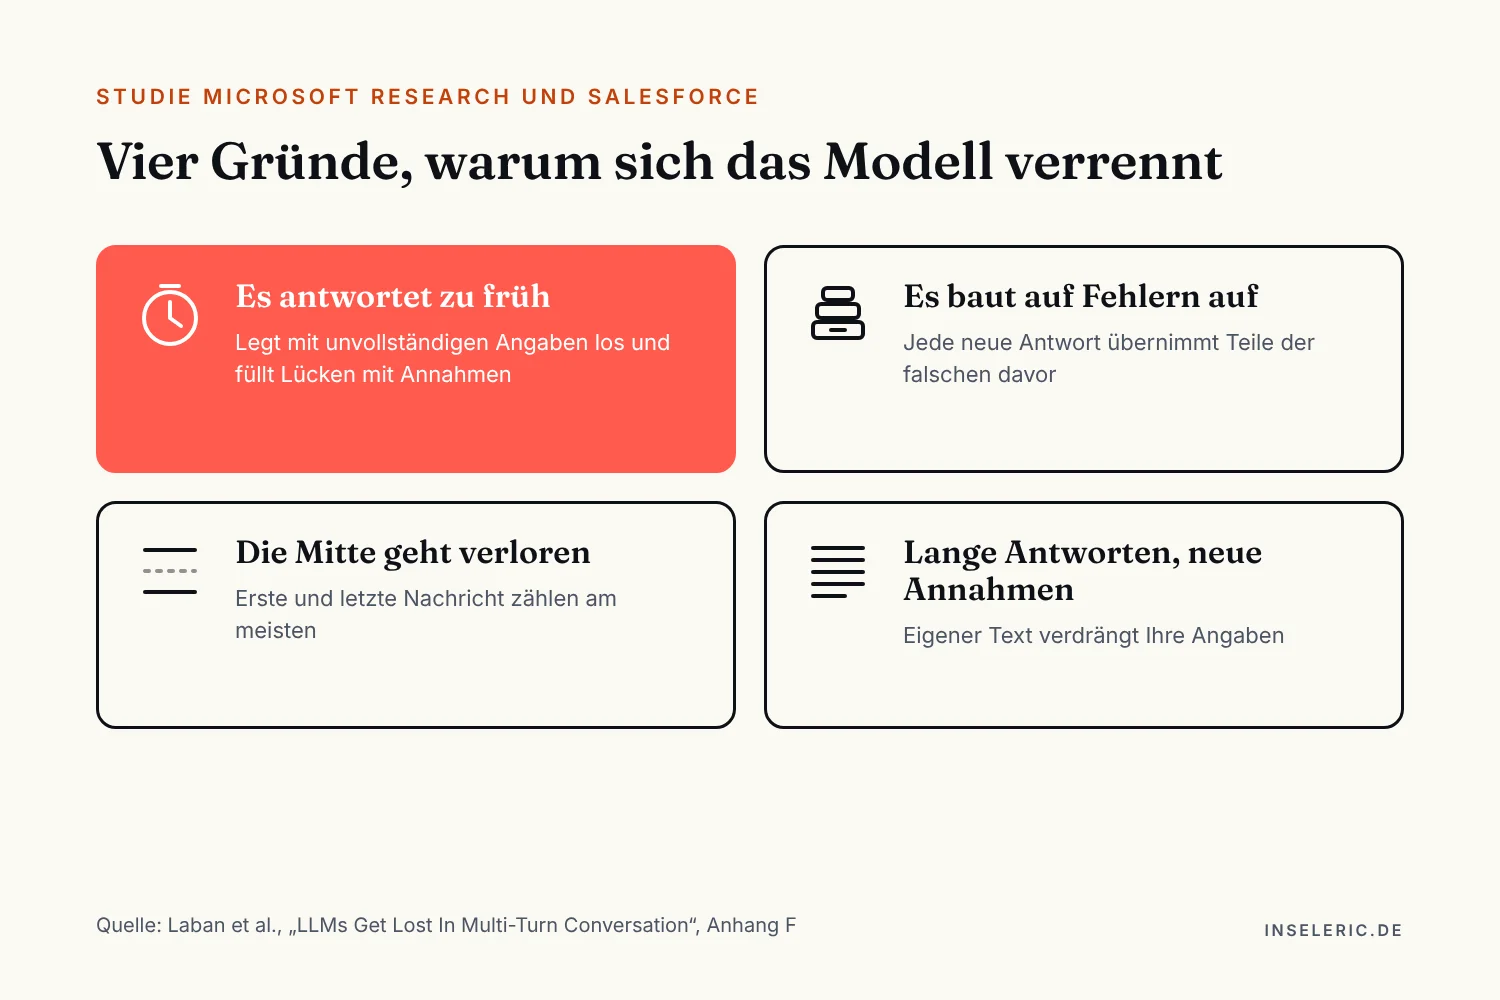
Vier Gründe, warum sich das Modell verrennt
Ein Bild vorweg. Sie sagen dem Schreiner „Küche, drei Meter“. Er sägt sofort die Arbeitsplatte zu. Danach sagen Sie „Spülmaschine links“. Er fängt nicht neu an, sondern flickt die zugeschnittene Platte. Die Studie nennt vier Ursachen:
- Es antwortet zu früh. Das Modell legt mit unvollständigen Angaben los und füllt die Lücken mit Annahmen
- Es baut auf eigenen Fehlern auf. Jede neue Antwort übernimmt Teile der falschen Antwort davor. Die Antworten werden länger statt besser
- Die Mitte geht verloren. Erste und letzte Nachricht bekommen das meiste Gewicht. Was dazwischen gesagt wurde, rutscht durch
- Lange Antworten erzeugen neue Annahmen. Je mehr das Modell selbst schreibt, desto mehr eigener Text steht zwischen Ihren Angaben
Damit löst sich auch der Widerspruch zu den Power-Usern auf. Getestet wurde, was passiert, wenn Pflichtangaben erst später kommen. Das Nachschärfen eines fertigen Entwurfs, wie es die Power-User beschreiben, hat die Studie nicht untersucht. Wer zuerst vollständig beauftragt und dann gezielt korrigiert, arbeitet anders als jemand, der seine Anforderungen erst im Gespräch zusammensucht.
Richtig prompten: fünf Empfehlungen, die die Studie hergibt
Die erste und die fünfte Empfehlung stützen sich auf Messungen der Studie, die dritte empfehlen die Autoren selbst. Die zweite und die vierte leite ich aus den Ursachen ab, die die Studie beschreibt. Getestet hat sie die Studie nicht.
1. Alles, was Sie wissen, in die erste Nachricht
Ziel, Kontext, Grenzen und Maßstab, also genau die vier Fragen der Power-User. Stichpunkte reichen. Merken Sie beim Schreiben, dass Ihnen eine Angabe fehlt, sammeln Sie erst und schicken dann.
2. Rückfragen gesammelt beantworten
Die Bitte um Rückfragen gegen die vorschnelle Antwort passt genau zur ersten Ursache. Allerdings kommen mit den Antworten wieder Angaben nach. Beantworten Sie deshalb alle Fragen in einer Nachricht. Bei größeren Aufgaben lassen Sie danach den vollständigen Auftrag zusammenfassen und starten damit neu.
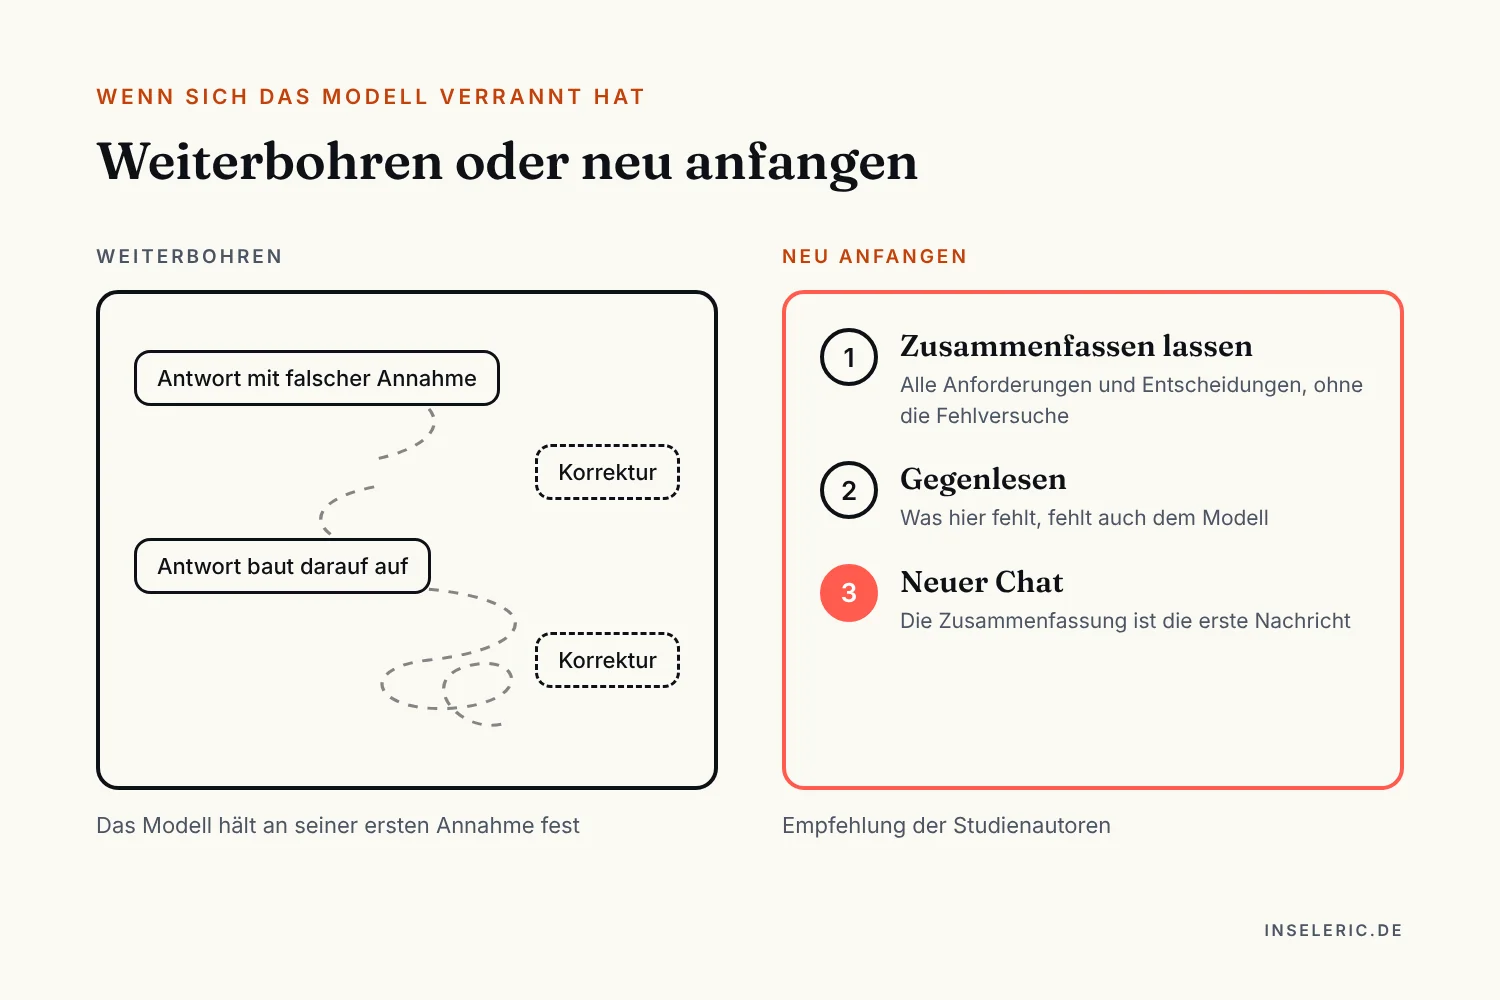
3. Festgefahren? Neu anfangen statt weiterbohren
Haben zwei Korrekturen nichts gebracht, bringt die dritte selten mehr. Das ist meine Erfahrung, die Studie nennt keine Zahl. Die Autoren empfehlen, das Modell alles Gesagte zusammenfassen zu lassen und mit dieser Zusammenfassung einen neuen Chat zu beginnen:
Fasse alle Anforderungen, Angaben und Entscheidungen aus diesem Gespräch in einem einzigen, vollständigen Auftrag zusammen. Lass Lösungsversuche und verworfene Ideen weg.
Lesen Sie die Zusammenfassung gegen, bevor Sie sie in den neuen Chat kopieren. Was dort fehlt, fehlt auch dem Modell.
4. Was immer gilt, fest hinterlegen
Hausregeln, Tonfall, Vorlagen und Hintergrundwissen ändern sich selten. In einer festen Anweisung laufen sie bei jedem Auftrag vollständig mit und müssen nicht nachgereicht werden: in Microsoft 365 Copilot als hinterlegte Anweisungen oder als eigener Agent aus Copilot Studio, in ChatGPT und Claude als Projekt. Ein Beispiel für den eigenen Schreibstil: zehn eigene gesendete Mails nehmen, Namen und Kundendaten entfernen, daraus Stilregeln ableiten lassen und diese als feste Anweisung hinterlegen.
5. Nicht auf Technik verlassen, selbst prüfen
Weder eine niedrigere Temperatur noch ein Denkmodell gleicht verteilte Angaben aus. In einem Test mit GPT-4o und GPT-4o-mini machte eine niedrigere Temperatur vollständige Aufträge deutlich verlässlicher, verteilte Gespräche kaum. Die Denkmodelle o3 und DeepSeek-R1 verloren ähnlich viel wie die übrigen. Bleibt die Gewohnheit der Power-User: Zahlen nachrechnen, Widerspruch verlangen, Entwurf und Prüfung trennen.
Was die Studie nicht zeigt
- Die Gespräche waren simuliert, ein Sprachmodell spielte den Nutzer. Die Autoren schreiben selbst, dass das echte Gespräche nicht abbildet, und vermuten, dass der Verlust im Alltag eher größer ist
- Getestet wurden Aufgaben mit überwiegend eindeutigem Ergebnis, auf Englisch. Freies Schreiben und Beratung waren nicht dabei
- Die Modelle stammen aus dem Frühjahr 2025. Laut THE DECODER kommen Laban und sein Team bei neueren Modellen ab GPT-5 auf 33 statt 39 Prozent Verlust. Eine begutachtete Veröffentlichung dazu habe ich nicht gefunden (Stand Oktober 2026)
- Microsoft 365 Copilot selbst wurde nicht getestet, wohl aber Modellfamilien, auf denen es aufbaut
Wenn Sie KI für Bilder nutzen: Dort gelten eigene Regeln, nachzulesen im Beitrag Prompts für KI-Bilder.
Ob Prompting im Team sitzt, zeigt sich nach drei Wochen
Auch das sagen die Power-User: Ein gemeinsamer Termin mit jemandem, der Fehler und Grenzen zeigt, senkt die Einstiegshürde deutlich. In meinen KI-Workshops arbeiten wir deshalb an echten Aufgaben aus Ihrem Haus, für die Geschäftsführung gibt es das 1:1-KI-Sparring. Der Einstieg ist eine kostenlose KI-Potenzialanalyse: 30 Minuten im Videogespräch, Sie bringen eine Aufgabe aus Ihrer Woche mit.
Quellen
- Laban, Hayashi, Zhou, Neville: LLMs Get Lost In Multi-Turn Conversation, arXiv, Mai 2025
- Vortrag auf der ICLR 2026, 23. April 2026
- Code und Testaufgaben der Studie auf GitHub
- THE DECODER: neuere Modelle ab GPT-5 verlieren 33 statt 39 Prozent, auf Englisch
- Power-User-Interviews, anonymisiert und zusammengefasst
Häufige Fragen
Wie setzen Power-User Microsoft 365 Copilot im Alltag ein?
Vor allem als Sparringspartner und für die ersten 70 bis 80 Prozent einer Aufgabe: Ideen und Entscheidungen durchdenken, Informationen ordnen, Entwürfe für Texte, Tabellen und Konzepte. Prüfen, gewichten und entscheiden bleibt bei ihnen. Auffällig ist, dass sie Copilot früh einsetzen, schon um die Aufgabe selbst zu klären, nicht erst für das fertige Dokument. Für wiederkehrende Abläufe bauen sie eigene Agenten in Copilot Studio.
Wie lang sollte ein guter Prompt sein?
So lang, dass Ziel, Kontext, Grenzen und Maßstab drinstehen. Für eine kurze Mail sind das drei Zeilen, für eine Entscheidungsvorlage eine halbe Seite. Stichpunkte reichen: In der Studie von Microsoft Research und Salesforce kamen sie auf 95 Prozent des Werts eines ausformulierten Auftrags.
Wann sollte ich einen neuen Chat beginnen?
Bei einer neuen Aufgabe immer. Bei derselben Aufgabe, sobald zwei Korrekturen nichts gebracht haben. Diese Schwelle ist ein Erfahrungswert, keine Zahl aus der Studie. Lassen Sie vorher alle Anforderungen zusammenfassen und beginnen Sie den neuen Chat mit dieser Zusammenfassung.
Gilt die Studie auch für Microsoft 365 Copilot?
Copilot selbst wurde nicht getestet. Getestet wurden unter anderem GPT-4o und GPT-4.1 von OpenAI, deren Nachfolger heute in Microsoft 365 Copilot arbeiten, dazu Modelle von Anthropic, die Copilot inzwischen ebenfalls nutzt, sowie von Google und Meta. Jedes Modell schnitt bei jeder Aufgabe schlechter ab, wenn die Angaben verteilt kamen.
Helfen Denkmodelle oder eine niedrigere Temperatur?
Laut Studie kaum. Die Denkmodelle o3 und DeepSeek-R1 verloren ähnlich viel wie die übrigen Modelle. Eine niedrigere Temperatur machte in einem Test mit GPT-4o und GPT-4o-mini vollständige Aufträge deutlich verlässlicher, Gespräche über mehrere Nachrichten dagegen kaum.
Muss ich Prompt Engineering lernen?
Nein. Die Power-User in den Interviews sagen: Programmierkenntnisse braucht es nicht. Entscheidend sind ein klares Ziel, die Fähigkeit, Ergebnisse kritisch zu prüfen, und die Bereitschaft, Schritt für Schritt neue Arbeitsweisen auszuprobieren.
Woher stammt die Studie?
„LLMs Get Lost In Multi-Turn Conversation“ von Philippe Laban, Hiroaki Hayashi, Yingbo Zhou und Jennifer Neville, Microsoft Research und Salesforce Research. Erschienen im Mai 2025 auf arXiv, 2026 auf der Fachkonferenz ICLR angenommen. Code und Testaufgaben sind öffentlich.