Kurz gesagt: Gute Prompts für KI-Bilder nennen zuerst die Gattung, beschreiben das Motiv mit Zutaten statt mit Adjektiven, geben jedem Referenzbild eine Rolle und enden mit einer Negativzeile. Beim Nachbessern ändern Sie eine Sache pro Runde. Damit zwanzig Bilder aussehen wie aus einer Hand, braucht es zusätzlich einen festen Stilblock, der vor jedem Auftrag steht.
Ein einzelnes Bild per Prompt erzeugen kann jeder. Zwanzig Bilder, die aussehen wie von einer Hand, gelingen den wenigsten. Gute Prompts für KI-Bilder lösen den ersten Teil. Den zweiten löst ein System, und ein System übersteht auch den Wechsel der Werkzeuge.
Wie schnell ein Werkzeug wegfällt, zeigt OpenAI: Die Sora-App ist seit April 2026 eingestellt, die Sora-API endete laut OpenAI am 24. September 2026, samt sora-2, sora-2-pro, allen Snapshots und der Videos API. Wer seinen Ablauf auf ein Werkzeug gebaut hat, fängt danach neu an. Wer ihn auf ein System gebaut hat, tauscht ein Werkzeug aus. (OpenAI Help Center, „What to know about the Sora discontinuation“, und developers.openai.com, Deprecations, geprüft am 01.10.2026)
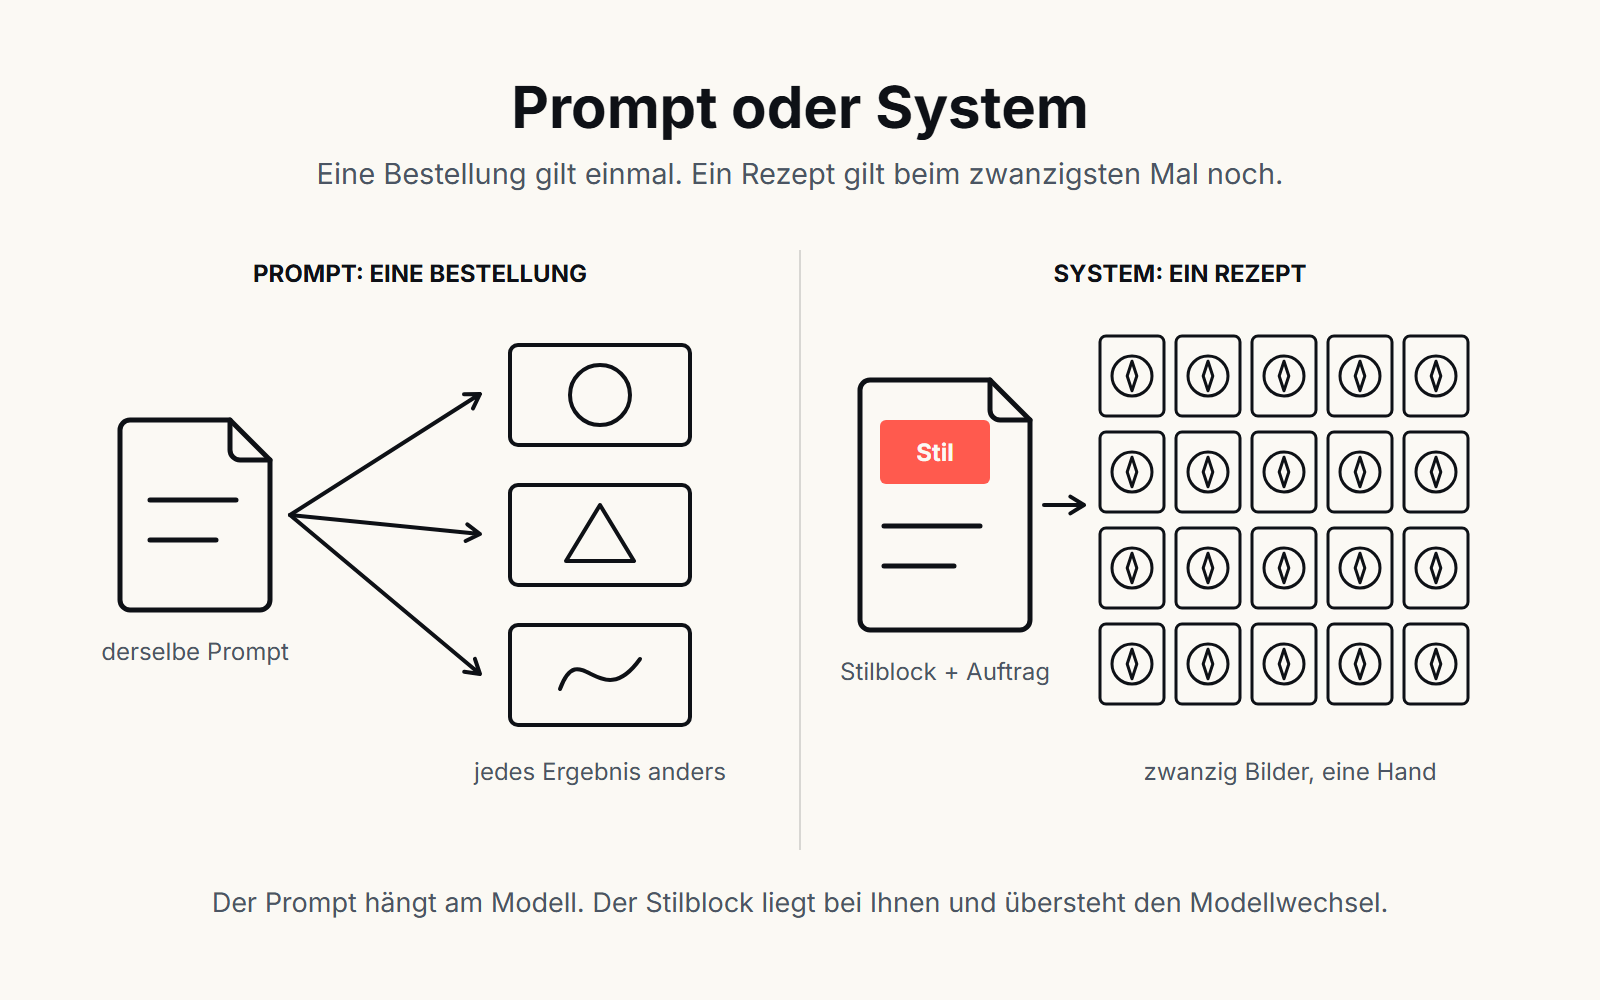
Ein Prompt ist eine Bestellung: Er gilt einmal und funktioniert beim nächsten Modell vielleicht noch, vielleicht nicht. Ein System ist ein Rezept: Es gilt beim zwanzigsten Mal noch, weil es nicht am Modell hängt.
Zutaten statt Adjektive: Was ein Bildmodell aus Ihrem Prompt liest
Adjektive beschreiben Ihre Erwartung, Zutaten beschreiben das Ergebnis. Das Modell kennt Ihre Erwartung nicht. Es kennt nur, was im Prompt steht.
Für ein Bildmodell ist ein Foto eine Menge von Zahlen. Sie sehen einen Sonnenuntergang am Meer, ruhig, warm, ein bisschen Wehmut. Das Modell sieht für jeden Bildpunkt drei Werte für Rot, Grün und Blau. Keiner dieser Werte heißt „Wehmut“.
Dazu kommt, wie das Bild entsteht. Das Modell malt nicht nach Gefühl. Es entscheidet Schritt für Schritt, was ins Bild gehört, je nach Bauart durch das Entfernen von Rauschen wie bei Googles Imagen oder durch das Setzen einzelner Bildbausteine nacheinander, wie OpenAI es für seine Bildgenerierung in GPT-4o beschreibt. Ihre Zutaten geben ihm diese Entscheidungen vor. „Umwerfend“ gibt ihm keine.
Am deutlichsten wird das in der Konditorei. Wer eine Torte mit dem Satz „Mach bitte eine schöne Torte“ bestellt, bekommt eine weiße Torte mit Kerzen. Er hat seine Erwartung beschrieben, und die Konditorin kennt sie nicht. Wer dagegen drei Stockwerke bestellt, Vanille-Mascarpone, handgefertigte Rosen in Altrosa, das Familienwappen als Zuckerstickerei auf der Mittelschicht und keinen Fondant, hat das Ergebnis beschrieben. Die weiße Torte ist nicht der Fehler der Konditorin.
Nach meiner Erfahrung hält eine Regel seit drei Jahren über jeden Modellwechsel hinweg: Vage rein, vage raus. Präzise rein, brauchbar raus.
Referenzbilder mit Rolle: zeigen statt formulieren
Ein Referenzbild bringt mehr als jede zusätzliche Formulierung, aber nur mit einer Rolle. Ohne Rolle mittelt das Modell aus allen Bildern. Heraus kommt ein Gesicht, das Ihnen ähnlich sieht und keinem gehört.
OpenAI schreibt dazu wörtlich: „Assign roles to references. Identify each input by number and purpose: subject, style, clothing, or background.“ (developers.openai.com, Image prompting, Abschnitt Prompting fundamentals, geprüft am 01.10.2026)
Mit drei eigenen Fotos sieht das bei mir so aus: Bild 1 liefert das Gesicht mit Zügen, Bart und Frisur. Bild 2 liefert nur Körperhaltung und Abstand zur Kamera. Bild 3 liefert nur Halbprofil und Bildausschnitt. Kleidung und Hintergrund kommen aus dem Prompt:
Bild 1: Gesicht, unverändert. Bild 2: nur Haltung. Bild 3: nur Ausschnitt.
Neue Szene: dieser Mann sitzt in der Ecke eines Boxrings auf dem Hocker, dunkelblauer Anzug, weißes Hemd, schwarze Boxhandschuhe, Handtuch über der Schulter. Hartes Spotlicht von oben, Halle dahinter dunkel. 85mm, offene Blende.
film grain, candid shot, not posed.
Unverändert bleiben: Gesicht, Bart, Frisur. Nicht übernehmen: das graue Musterhemd, den hellen Innenraum.
Der einfache Auftrag mit denselben drei Fotos lautete: „Hier sind drei Bilder von mir. Mach ein professionelles Foto von mir als KI-Berater.“ Dabei rät das Modell Ort, Licht, Kleidung und Ausschnitt und mittelt die drei Gesichter.
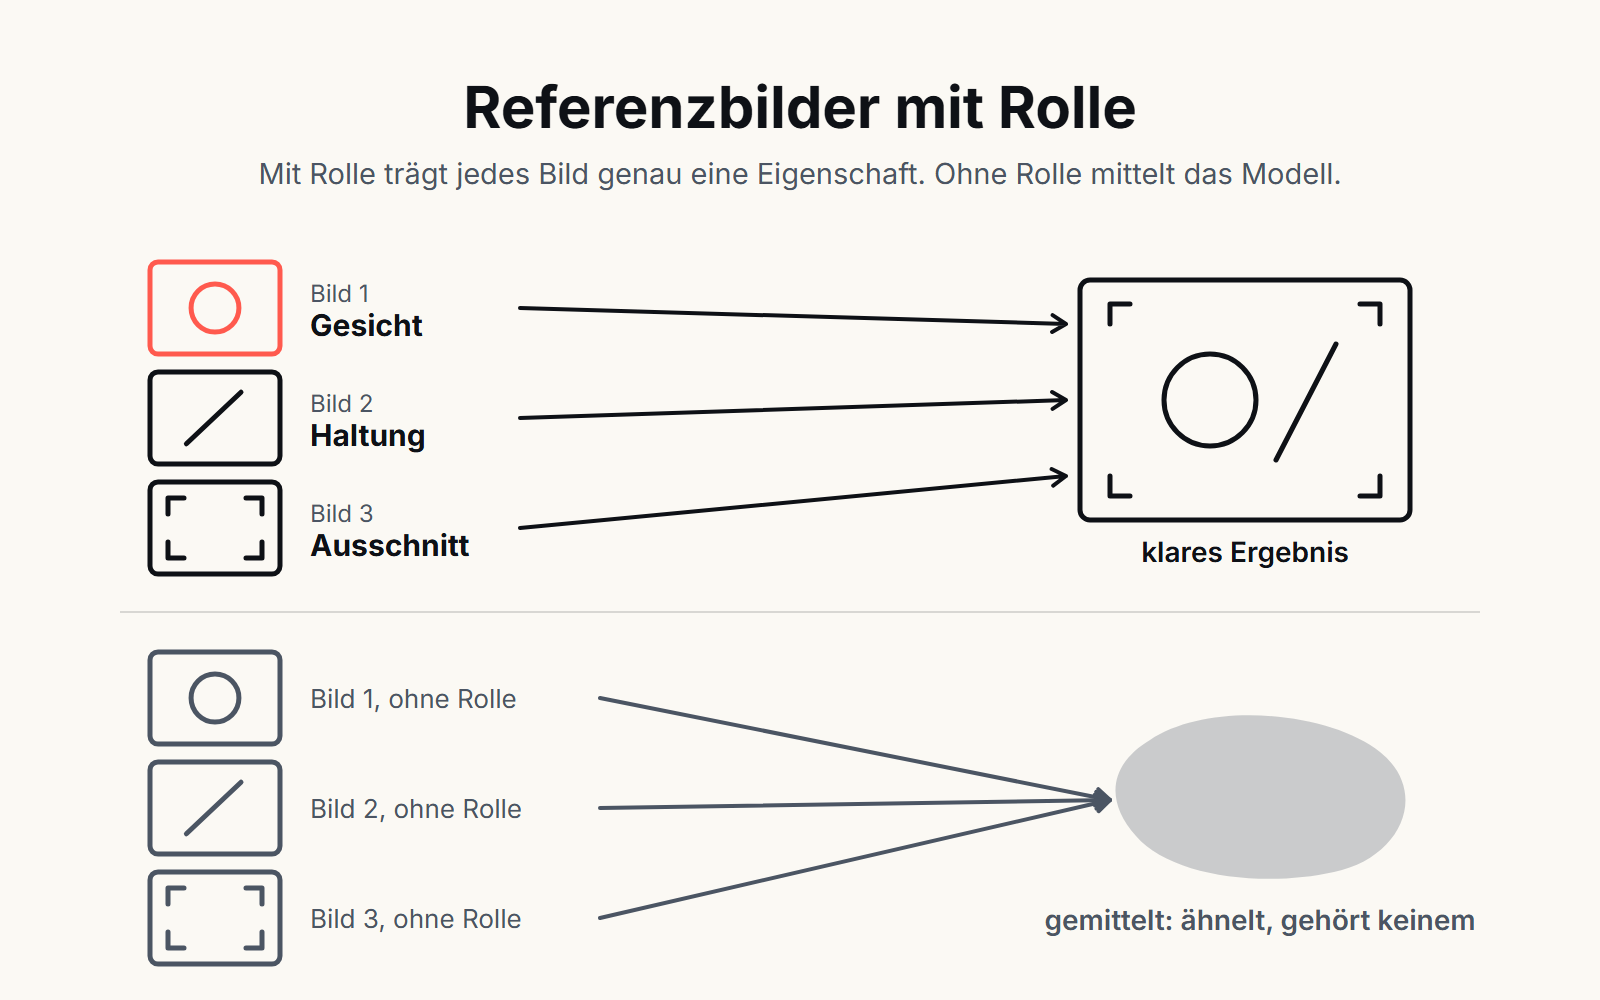
Soll ein Gesicht über viele Bilder gleich bleiben, brauchen Sie drei bis fünf Porträts aus verschiedenen Winkeln. Meine drei Fotos stammen aus einer Sitzung, deshalb trägt nur Bild 1 das Gesicht. Für Nano Banana Pro nennt Google bis zu 14 Referenzbilder, laut API-Dokumentation davon bis zu 5 Personen, 6 Objekte und 3 Stilvorlagen (Herstellerangabe, ai.google.dev, geprüft am 01.10.2026). Fünf verschiedene Personen in einem Bild habe ich nie gebraucht, drei bleiben bei mir stabil.
KI-Bilder nachbessern: eine Änderung pro Runde
Ändern Sie beim Nachbessern genau eine Sache, und zählen Sie auf, was gleich bleiben muss. Wer drei Dinge auf einmal ändert, bekommt vielleicht ein besseres Bild. Er weiß aber nicht, welche Änderung es war, und kann das Ergebnis beim nächsten Mal nicht wiederholen.
Der Satzbau, der funktioniert:
Ändere nur die Jacke zu dunkelgrün.
Unverändert bleiben: Gesicht, Körperhaltung, Bildausschnitt, Licht, Hintergrund, Schrift im Bild.
OpenAI empfiehlt dasselbe: „say ‚change only X‘ and list the details to preserve.“ (developers.openai.com, Image prompting, Abschnitt Prompting fundamentals, geprüft am 01.10.2026) Die Erhaltungsliste wiederholen Sie bei jeder Runde, nicht nur bei der ersten.
Achten Sie auf die Reihenfolge: Das Ergebnis der vorigen Runde ist der Eingang der nächsten, nicht der ursprüngliche Prompt. Mit jeder einzelnen Änderung lernen Sie, was wirkt. Das ist der ganze Unterschied zwischen einem Glückstreffer und einem System: Ein Glückstreffer ist ein Bild. Ein System sind zwanzig.
Warum KI-Bilder zu glatt aussehen
Ein KI-Bild fällt selten durch einen Fehler auf. Es fällt durch das Fehlen von Fehlern auf: kein Korn, kein Staub, keine schiefe Kante, kein unaufgeräumter Hintergrund. So sieht kein Foto aus.
Abhilfe schaffen kurze Bausteine im Prompt, etwa „film grain“, „macro detail“, „casual lighting“ oder „candid shot, not posed“. Nehmen Sie zwei bis drei je Bild, nicht alle auf einmal. Sonst wissen Sie wieder nicht, welcher gewirkt hat.
Belegt ist davon nur ein Teil. „film grain“, „textured brushstrokes“ und „macro detail“ stehen wörtlich im Leitfaden von OpenAI (developers.openai.com/cookbook, GPT Image Generation Models Prompting Guide, 21.04.2026, inzwischen archiviert). Die übrigen Bausteine stammen aus meiner eigenen Sammlung. Ihre Wirkung ist nicht einzeln belegt.
Prompt-Beispiel für KI-Bilder: Gattung vorn, Negativzeile hinten
Zwei Zeilen rahmen jeden brauchbaren Bildprompt: vorn die Gattung, hinten die Ausschlüsse.
Der erste Halbsatz nennt die Gattung, also Produktfoto, Anzeige, Diagramm oder Porträt. Das Modell setzt danach seine Voreinstellungen. So steht es im Leitfaden von OpenAI (developers.openai.com), dort stehen auch die Referenz mit Rolle und die Erhaltungsliste aus den Abschnitten davor.
Die letzte Zeile ist eine Negativzeile: keine Schrift, keine Zahlen, keine fremden Logos, dazu das Seitenverhältnis. Das ist eigene Praxis und kein Herstellerhinweis. Bei mir spart sie die halbe zweite Runde.
Zusammengesetzt sieht ein Auftrag zum Beispiel so aus. Die Bezeichnungen am Zeilenanfang dürfen stehen bleiben. Sie schaden nicht und helfen Ihnen beim Nachbessern:
Gattung: Produktfoto für einen Onlineshop.
Motiv: ein Sneaker mit geflochtenem Obermaterial in Sandbeige, schwarze Schnürsenkel, auf hellem Beton. Weiches Tageslicht von links oben, ein langer Schatten, ein paar Sandkörner. 50mm, geringe Schärfentiefe.
Referenz: Bild 1 ist das Produktfoto. Den Schuh exakt so übernehmen, nichts daran verändern.
Echtheit: film grain, macro detail.
Ausschluss: keine Menschen, keine Hände, keine Schrift, keine fremden Logos. Seitenverhältnis 4:5.
Ein Bild wie dieses müssen Sie übrigens kennzeichnen: Es zeigt ein echtes Produkt in einer Szene, die nie fotografiert wurde. Warum, steht in den Fragen am Ende.
Mit diesen Regeln gelingt ein gutes Einzelbild. Für zwanzig Bilder aus einer Hand reicht das nicht. Dafür braucht es eine Entscheidung, bevor der erste Prompt geschrieben ist.
Zwei Sorten Bild: Foto oder Schaubild
Legen Sie zuerst fest, welche Sorte Bild Sie brauchen, denn die beiden haben nichts miteinander zu tun. Das inszenierte Foto sieht aus wie fotografiert und wird daran gemessen, ob man den Unterschied merkt. Das erklärende Schaubild sieht aus wie gezeichnet und wird daran gemessen, ob man die Sache danach versteht.
Wer berät, schult oder erklärt, hat seinen Vorsprung meist beim Schaubild. Ich habe mich deshalb gegen eine ganze Gattung entschieden: Schaubilder komplett mit KI, fotorealistische Bilder bewusst nicht. Website und Blog sollen sich lesen wie ein Buch, und in einem Buch stehen Zeichnungen.
Eine Bildentscheidung ist eine Markenentscheidung, keine Werkzeugfrage. Aus ihr folgt der Rest: ein Akzentton als Hex-Wert und kein zweiter, zwei Schriften, Linien statt gefüllter Flächen, eigene Motive statt Bildern aus Bilddatenbanken, eigene Sätze als hervorgehobene Zitate.
Der Stilblock: Ihre Bildsprache in einem Absatz
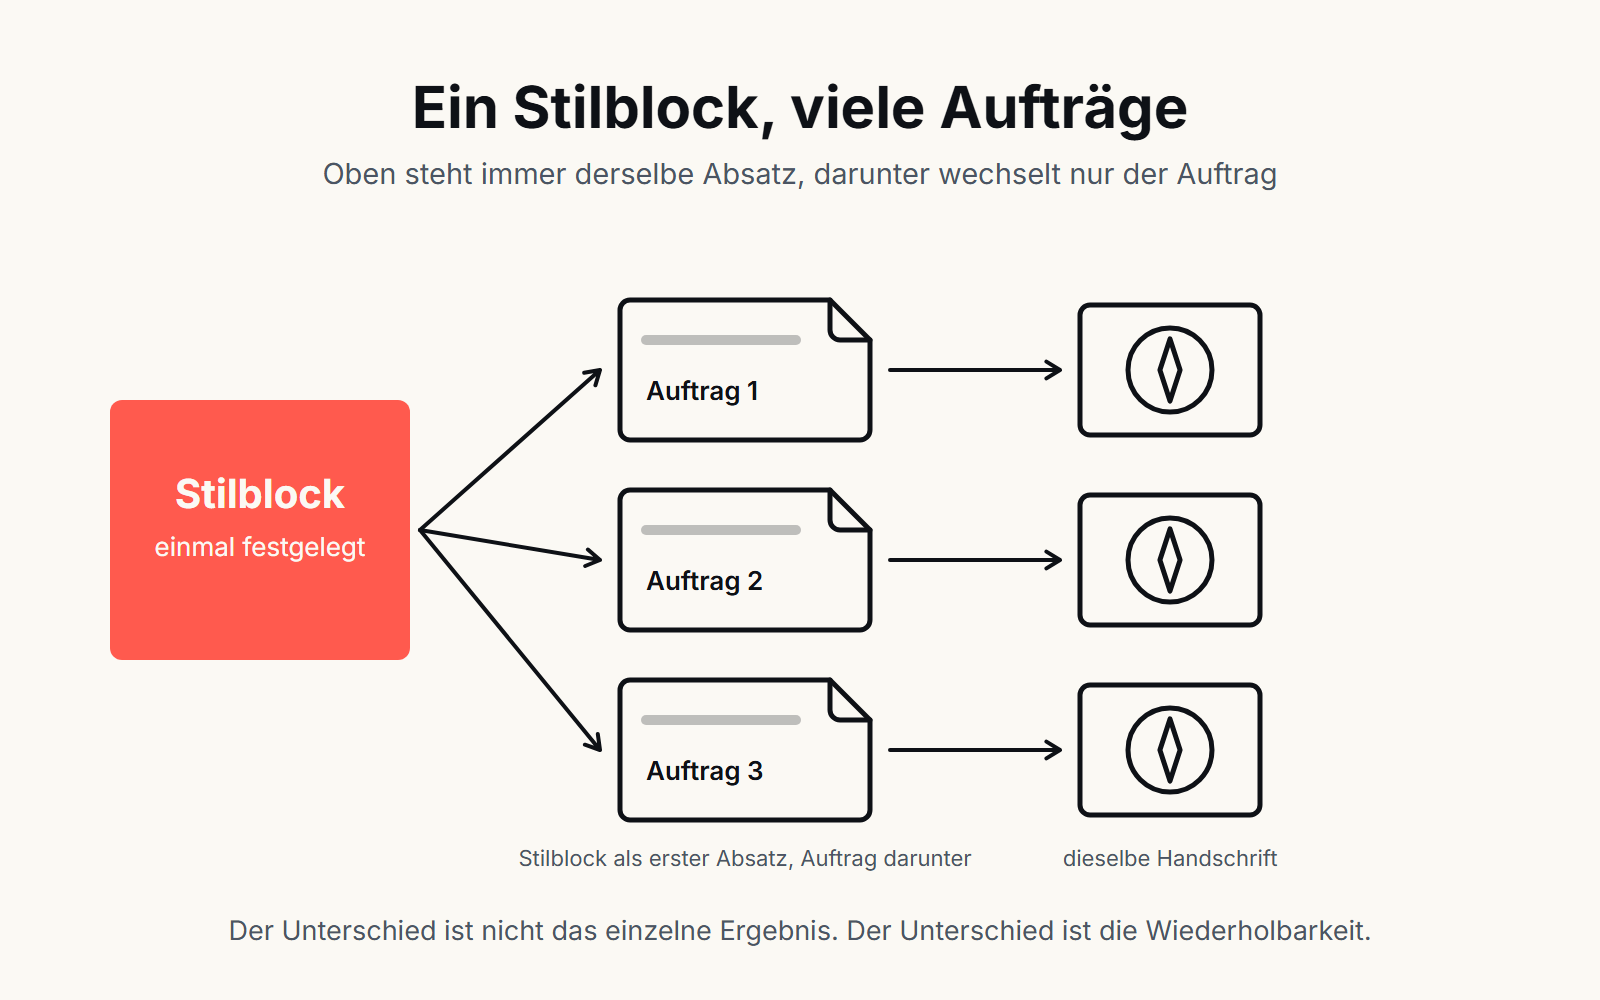
Ein Stilblock ist ein Absatz, den Sie einmal festlegen und vor jeden Bildauftrag setzen. Danach ist jeder weitere Auftrag ein Satz. Der Unterschied liegt nicht im einzelnen Ergebnis, sondern in der Wiederholbarkeit: Ohne System fangen Sie jedes Mal von vorn an, mit System steht der Block schon.
Der Block entsteht aus Antworten, nicht aus Adjektiven. Ich lasse ihn von einem Sprachmodell erarbeiten, das mir Fragen stellt, erst zum Material, dann in drei Fragerunden:
- Material: Logo, ein Bildschirmfoto der Website, Präsentationen, eigene Fotos und fremde Bilder, deren Wirkung Ihnen gefällt. Das Modell liest daraus Farbe, Form und Leerraum. Nach einem Farbwert fragt es nie.
- Wer und was: was Sie machen und für wen, drei Wörter, die Ihre Bilder auslösen sollen, und drei, die sie nie auslösen dürfen.
- Wo und was nicht: die drei Orte, an denen Ihre Bilder erscheinen, wiederkehrende Motive aus Ihrer Arbeit und alles, was auf keinem Bild vorkommen darf.
- Machart: Foto, Schaubild oder beides, Menschen im Bild oder nicht.
Meine Antworten als Beispiel: klar, ruhig, belastbar, nie laut, verspielt oder generisch. Motive aus eigener Arbeit sind Fahrplan, Ampel und Kompass. Auf keinem Bild erscheinen Motive aus Bilddatenbanken, Roboter, leuchtende Gehirne oder Schrift. Nur die letzte Runde versteht ein Bildmodell direkt. Die Runden davor sorgen dafür, dass sie nicht geraten ist.
Am Ende stehen sechs Teile: der Stilblock mit zwölf Zeilen als Anweisung an ein Bildmodell, drei Vorlagen, eine Regel für Referenzbilder, auf Wunsch Angaben zu Video, die Ablage und ein fertiger Beispielauftrag. Der Stilblock steht bei jedem Bild als erster Absatz, der Auftrag darunter.
Die Schaubilder in diesem Beitrag folgen denselben Regeln: ein Akzentton, Linien statt Flächen, keine Schrift aus einem Bildmodell.
Prompts für KI-Bilder dauerhaft ablegen
Ein System im Chatfenster ist kein System. Legen Sie den Stilblock zuerst als Textdatei bei sich ab, das ist das Original. Danach kommt eine Kopie an einen Ort im Werkzeug, der nur bei Bildaufgaben geladen wird: ein Skill in Claude oder ein Gem in Gemini. Beides geht nach meinem Stand vom 1. Oktober 2026 schon im kostenlosen Plan. Im Vortrag am 23. September stand dazu noch eine andere Angabe, sie ist überholt.
In ChatGPT ist dieser Ort gerade weggefallen. Eigene GPTs lassen sich in privaten Konten nicht mehr neu anlegen, auch nicht mit Abo, OpenAI löst sie durch Plugins ab (OpenAI Help Center, Creating and editing GPTs, geprüft am 01.10.2026). Dort legen Sie das System ungekürzt in ein Projekt. Es ist dieselbe Lehre wie bei Sora: Die Textdatei überlebt, der Ablageort nicht immer. Wie ein Ablageort sauber gebaut wird, zeige ich am Beispiel Langdock im Beitrag Langdock Skills richtig bauen.
Fertig ist so ein System nie. Passt ein Ergebnis nicht, ändern Sie eine Zeile im Stilblock, nicht fünf. Die Werkzeuge werden nächstes Jahr andere heißen. Ihre Entscheidungen nicht.
Was in diesem Beitrag bewusst fehlt
Der Vortrag hatte drei Runden, hier steht die erste. Die beiden anderen bleiben den Teilnehmenden vorbehalten: eine Formel aus sechs Zeilen für KI-Video, bei der die letzte Zeile über den Ton entscheidet, und ein Test aus drei Fragen, den jedes eigene Bild und Video vor der Veröffentlichung bestehen muss. Ebenfalls nicht hier steht der Metaprompt, der die drei Fragerunden führt und den Stilblock ausgibt.
Wenn Sie eine Bildsprache für Ihr Team aufbauen wollen, geht das als Workshop oder im KI-Sparring. Den Vortrag selbst finden Sie unter den vergangenen Terminen.
Häufige Fragen
Wie ist ein guter Prompt für ein KI-Bild aufgebaut?
In fünf Teilen: zuerst die Gattung, dann das Motiv mit Zutaten statt Adjektiven, jedes Referenzbild mit Nummer und Rolle, zwei bis drei Bausteine gegen die zu glatte Wirkung und am Ende eine Negativzeile mit Seitenverhältnis. Beim Nachbessern ändern Sie pro Runde genau eine Sache und zählen auf, was gleich bleiben muss.
Sind englische Prompts für Bildmodelle besser?
Das ist nicht belegt. Für Imagen führt Google Deutsch offiziell als Sprache für Prompts, für die Gemini-Bildmodelle nennt Google keine Sprachliste. Kein Anbieter behauptet, dass englische Bildprompts bessere Ergebnisse liefern. Schreiben Sie in der Sprache, in der Sie am genauesten beschreiben können. (Eigene Quellenprüfung, Stand 01.10.2026)
Helfen Zusätze wie „8K“ oder „award-winning photography“?
Für eine Wirkung gibt es keinen Beleg. Solche Zusätze stehen in keinem offiziellen Leitfaden von Google oder OpenAI. Dass sie schaden, ist ebenfalls nicht belegt. Wirksamer sind Gattung, Zutaten und eine Negativzeile. (Eigene Quellenprüfung, Stand 09.09.2026)
Sind Prompts im JSON-Format besser als normaler Text?
Nicht erkennbar. OpenAI stellt JSON gleichwertig neben Fließtext, und einen Beleg für bessere Bilder durch JSON habe ich nicht gefunden. Entscheidend ist, was im Prompt steht, nicht die Form. (Eigene Quellenprüfung, Stand 09.09.2026)
Wie bleibt mein Gesicht über mehrere Bilder gleich?
Mit drei bis fünf Porträts aus verschiedenen Winkeln, jedes mit einer klaren Rolle im Prompt. Fotos aus einer einzigen Sitzung mit gleicher Kleidung, gleichem Licht und gleichem Winkel wirken wie ein einziges Bild. Dann sollte nur eines davon das Gesicht tragen.
Muss ich KI-Bilder kennzeichnen?
Bei beruflicher Nutzung ja, wenn das Bild wie eine Aufnahme wirkt, etwas zeigt, das es gibt oder geben könnte, und der Betrachter es für echt hält. Dann gilt seit dem 2. August 2026 die Pflicht nach Art. 50 Abs. 4 KI-VO, auch bei einem Gegenstand wie Ihrem Produkt. Ein erkennbares Schaubild fällt nicht darunter. Und: Eine Kennzeichnung heilt keine Irreführung, etwa mit fremden Marken im Bild. (Art. 50 Abs. 4 und Art. 3 Nr. 60 KI-VO, Leitlinien der Kommission vom 20.07.2026. Keine Rechtsberatung)
Welches Werkzeug soll ich nehmen?
Eine Werkzeugliste wäre in wenigen Wochen veraltet, deshalb nenne ich hier keine. Ein Stilblock ist reiner Text und läuft in jedem dieser Werkzeuge. Claude erzeugt allerdings keine Fotos, sondern baut Schaubilder als Code. Wie Sie ein Werkzeug nach Ihrer Aufgabe auswählen, steht im Beitrag KI-Tools auswählen. Eine Orientierung nach Aufgabe bietet der KI Tool Kompass.
Über den Autor: Eric Insel ist KI-Sparringspartner für KMU und regulierte Branchen und Dozent, unter anderem bei Digital Beat. Mehr auf der Seite Über mich. Wenn Sie Ihre eigene Bildsprache mit jemandem aufbauen wollen, der widerspricht: KI-Sparring.
Quellen
- OpenAI Help Center, „What to know about the Sora discontinuation“, geprüft am 01.10.2026
- developers.openai.com, Deprecations, geprüft am 01.10.2026
- developers.openai.com, Image prompting, Abschnitt Prompting fundamentals, geprüft am 01.10.2026
- developers.openai.com/cookbook, GPT Image Generation Models Prompting Guide, 21.04.2026, archiviert
- ai.google.dev, Gemini API, Bildgenerierung, Angaben zu Referenzbildern (Herstellerangabe), geprüft am 01.10.2026
- docs.cloud.google.com, Vertex AI, Set text prompt language (Imagen), Stand 30.09.2026, geprüft am 01.10.2026
- OpenAI, GPT-4o Native Image Generation System Card (Bildgenerierung autoregressiv), geprüft am 01.10.2026
- OpenAI Help Center, „Creating and editing GPTs“, geprüft am 01.10.2026
- support.claude.com, „Use Skills in Claude“, geprüft am 01.10.2026
- KI-VO, Art. 50 Abs. 4 und Art. 3 Nr. 60; Leitlinien der Kommission zu den Transparenzpflichten vom 20.07.2026
- Eigene Quellenprüfung zu Qualitätsmarkern und JSON, Stand 09.09.2026